wo_men_path <- "https://raw.github.com/sebastiansauer/modar/master/datasets/wo_men.csv"
d <- read_csv(wo_men_path)hyp-women-03
Question
Der Datensatz wo_men Untersucht Geschlechtsunterschiede u.a. in Körpergröße.
Sie können ihn hier herunterladen:
Testen Sie anhand dieses Datensatzes folgende Hypothese \(H\):
“Männer sind im Schnitt größer als Frauen!”
Präziser formuliert:
\(X_M > X_F\), wobei \(X\) die Größe einer zufällige gezogenen Person angibt (in der Population, auch Erwartungswert genannt). \(M\) steht für Männer, \(F\) für Frauen.
Über die Hypothese soll anhand folgender Entscheidungsregel \(R\) entschieden werden:
- $Pr(p|D,H) > .95 H $ annehmen
- $Pr(p|D,H) < .05 H $ verwerfen
- ansonsten: keine Entscheidung bzgl. \(H\) aufgrund uneindeutiger Evidenz
Dabei benennt \(Pr(p|D,H)\) die Wahrscheinlichkeit auf Basis der PPV, dass ein beliebiger Mann ein höheres Gewicht hat als eine beliebige Frau (d.h. zufällig gezogen).
Geben Sie die gesuchte Wahrscheinlichkeit als Lösung an!
Solution
Betrachten wir zunächst die Daten:
d %>%
  ggplot(aes(x = height, fill = sex)) +
  geom_density()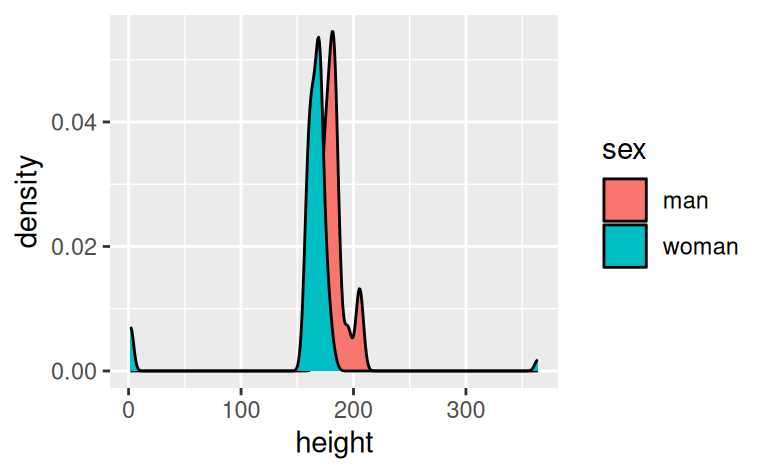
Wie man sieht, scheint es einige “komische” Werte zu geben. Besser wir entfernen diese vorab.
d2 <-
  d %>%
  filter(between(height, 150, 210))
lm2 <- stan_glm(height ~ sex, data = d2, refresh = 0)Berechnen wir dann die PPV. Dabei interessieren uns zwei Ausprängungen, nämlich woman und man. Wir brauchen also nur diese zwei Beobachtungen:
lm2_ppv <-
  posterior_predict(lm2, newdata = tibble(sex = c("woman", "man"))) %>%
  as_tibble()
Schauen wir uns die PPV an:
lm2_ppv %>%
head()| 1 | 2 |
|---|---|
| 162.4720 | 174.6069 |
| 169.8292 | 176.9536 |
| 168.1383 | 181.1307 |
| 177.0993 | 186.7268 |
| 179.3451 | 181.5614 |
| 147.5758 | 173.5806 |
Die Tabelle lm1_ppv hat 4000 Zeilen, das ist jeweils eine Stichprobe aus der PPV. Die Tabelle hat 2 Spalten, das sind die zwei Beobachtungen woman und man, Personen also.
Jetzt schauen wir für jede der 4000 Stichproben, wie oft der Mann größer war:
lm2_ppv <-
  lm2_ppv %>%
  mutate(mann_ist_groesser = `1` < `2`)

lm2_ppv %>%
head()| 1 | 2 | mann_ist_groesser |
|---|---|---|
| 162.4720 | 174.6069 | TRUE |
| 169.8292 | 176.9536 | TRUE |
| 168.1383 | 181.1307 | TRUE |
| 177.0993 | 186.7268 | TRUE |
| 179.3451 | 181.5614 | TRUE |
| 147.5758 | 173.5806 | TRUE |
Und dann zählen wir aus, wie oft in den 4000 Stichproben der Mann größer war, also wie oft mann_ist_groesser == TRUE gilt.
lm2_ppv %>%
summarise(prop_mann_ist_groesser = mean(mann_ist_groesser))| prop_mann_ist_groesser |
|---|
| 0.94525 |
Vielleicht wundern Sie sich, dass wir hier den Befehl mean verwendet haben. Praktischerweise kann mean() auch logische Variablen verarbeiten. mann_ist_groesser ist eine logische Variable (Typ lgl, logical); die Variable hat nur die Werte TRUE und FALSE. Dabei zählt mean() für jedes TRUE eine 1 und für jedes FALSE eine 0. Diese Summe wird durch die Anzahl der Zeilen, also \(n\), geteilt: Voilà, der Mittelwert.
Wie man sieht ist die Verteilung des Mittelwertsunterschieds in der PPV ziemlich eindeutig: Nur mit geringer Wahrscheinlichkeit geht das Modell davon aus, dass eine beliebige (zufällig gezogene) Frau einen höheren Mittelwert (in der Population) aufweisen als ein beliebiger Mann. Anders gesagt: Mit hoher Gewissheit geht das Modell davon aus, dass ein zufällig gezogener Mann einen höheren Mittelwert aufweist (als eine zufällig gezogene Frau).
Lassen wir uns den genauen Anteil ausgeben:
anteil_beliebiger_mann_ist_groesser <-
  lm2_ppv %>%
  summarise(prop_mann_ist_groesser = mean(mann_ist_groesser)) %>%
  as.numeric()

anteil_beliebiger_mann_ist_groesser
[1] 0.94525Da die Tabelle nur aus einer Zelle besteht, wandeln wir sie mit as.numeric() in einen numerischen Wert um, also eine einfache Zahl in diesem Fall.
Mann kann den Anteil natürlich einfach aus der Tabelle ablesen, aber man kann ihn sich auch von R ausgeben lassen; das tut hier nicht wirklich Not. Es würde reichen, wenn Sie den Wert einfach hinschreiben.
Die Antwort (solution, sol) lautet also, laut diesem Modell (mit gegebener Simulationsvarianz):
sol <- anteil_beliebiger_mann_ist_groesser
round(sol, 2)
[1] 0.95Aufgabenname: hyp-women-03
Meta-information
exname: hyp-women-03 extype: num exsolution: 0.94525 extol: .05 expoints: 1